C’est la rentrée, on reprend pour beaucoup le travail et les réseaux sociaux. Mais vous avez sûrement remarqué un sujet qui était beaucoup moins présent avant : Hermes. Car pendant que vous étiez tranquillement à la plage, une grosse partie de la tech s’est mise à parler de cet agent IA, sorti à première vue de nulle part. Je vous entends déjà : encore une techno éphémère à la OpenClaw. Elle va disparaître dans 6 mois après avoir fait naître un nouveau FOMO (Fear Of Missing Out) dans une grosse partie de la communauté tech. Pour éviter ça, je vous propose qu’on le teste ensemble et qu’on se fasse un premier avis. Rassurez-vous, tout va bien se passer.
Qu’est-ce que c’est, au juste, Hermes ?#
Hermes est une entreprise française du secteur du luxe… heu, attendez, non, mauvais script. Hermes est un framework d’agent — dit comme ça, ça reste un peu flou. Reprenons donc autrement.
À noter : je ne parlerai pas de la version desktop, qui ressemble plus à Claude Cowork dans l’idée.
Vous utilisez sûrement un agent sur votre ordinateur pour vous aider dans le développement : Claude Code, Kilo, OpenCode et bien d’autres. Par la configuration et l’ajout de plugins, vous pouvez globalement combler ces manques — connecteurs, systèmes de collaboration, etc. Malgré ça, vous restez souvent condamné à vous déplacer, le doigt glissé entre l’écran et le clavier de votre MacBook, pour éviter de couper la session en cours de l’agent. En bref, ça fonctionne, mais ce n’est jamais parfait et il reste souvent des lacunes.
C’est là qu’on voit apparaître Hermes, qui se veut être un agent “battery included”, comme on dirait. Dès l’installation, il va vous guider pour le paramétrer, l’interconnecter avec votre chat favori et configurer un certain nombre de MCP/connecteurs dès le départ. Une fois installé, la seconde grande promesse est qu’il sera bien plus autonome et surtout capable de s’améliorer et d’apprendre. Un point très intéressant : l’éditeur d’Hermes, NousResearch, a une vision open source et non verrouillée des choses, ce qui est pour moi une grosse force. Il existe d’ailleurs une version en PaaS, mais je ne vais pas en parler : on va l’installer nous-mêmes.
Comment ça s’installe#
La première étape va être de trouver où installer votre serveur. On voit souvent recommander des Mac mini, en raison de leur excellent rapport performance/prix pour une consommation maîtrisée. Je vous avoue que je trouve le Mac mini très souvent overkill dans ce cas, surtout pour débuter. Un petit VPS, ou un vieux PC qui traîne, fera largement l’affaire, a minima dans un premier temps.
Vous pouvez trouver ça étrange de partir sur des machines peu puissantes pour de l’IA. Mais dans mon cas, comme beaucoup, je ne fais pas tourner de modèles locaux et ce sera le cas dans la suite.
J’utilise un VPS avec 2 vCPUs et 2 Go de mémoire, un vieux VPS que j’avais souscrit et qui me suffit globalement pour Hermes. Néanmoins, si vous le pouvez, je vous recommande de prendre un serveur avec a minima 4 Go de mémoire vive.
Docker#
Docker est le choix un peu par défaut conseillé par Hermes. Il vous suffit de lancer l’image en mode setup avec les options données dans la documentation officielle .
J’ai modifié l’image pour y ajouter quelques éléments absents de base. J’en parlerai plus tard dans l’article. Mon image reste simple et elle est disponible publiquement :
- Github : DamyrFr/hermes-docker
- Dockerhub : Damyr/hermes-docker
Je passe par un docker-compose, ce qui me permet de gérer un premier niveau de configuration. Parmi les éléments qu’elle regroupe : l’exposition, qui doit toujours passer par un VPN (via la variable HERMES_BIND_ADDR), et quelques paramètres de sécurité plus classiques. Voici un extrait, le reste est disponible sur le GitHub :
services:
  hermes:
    [...]
    # ne pas donner plus de privilège que ceux au démarrage
    security_opt:
      - no-new-privileges:true
    # retire tous les privilèges unix par défaut
    cap_drop:
      - ALL
    # autorise uniquement les privilèges nécessaires
    cap_add:
      - CHOWN
      - FOWNER
      - DAC_OVERRIDE
      - SETUID
      - SETGID
      - KILL
    # Eviter des bugs avec trop de fd ouverts
    ulimits:
      nofile:
        soft: 4096
        hard: 8192
    ports:
    # On définit une adresse précise et un port pour l'exposition
      - "${HERMES_BIND_ADDR}:${HERMES_DASHBOARD_PORT:-9119}:${HERMES_DASHBOARD_PORT:-9119}"
La configuration de l’agent se fait par l’intermédiaire d’une Text User Interface par défaut. Tout est bien sûr aussi possible via un fichier de configuration. Néanmoins, lors du premier run, je vous conseille de suivre les étapes. Vous pouvez, dans un premier temps, laisser de côté les paramètres qui vous semblent obscurs.
Kubernetes#
Techniquement, on peut faire tourner Hermes dans Kube, en n’oubliant pas de créer un volume pour /opt/data. Mais comme j’avais un VPS sous la main, je l’y ai laissé pour le moment. Si vous avez des retours d’expérience là-dessus, ça m’intéresse — n’hésitez pas à les partager.
Arborescence#
Une fois lancé, vous allez retrouver l’arborescence de fichiers d’Hermes dans le dossier /opt/data, que le guide vous fait mapper dans un volume avec l’hôte. Voyons rapidement les fichiers et dossiers que je trouve importants :
- config.yaml : les paramètres globaux, les modèles à utiliser, les outils dont dispose l’agent, etc.
- skills : les procédures que l’agent va apprendre et améliorer.
- state.db : on n’y touche pas, sauf pour backup (et jamais par simple copie) — c’est toute la mémoire de l’agent : sessions, historiques, etc.
- .env et auth.json : les clés d’API pour le premier, les authentifications type Discord pour le second.
- cron : assez parlant, ce sont les jobs planifiés, des crons des plus classiques.
- SOUL.md : on en reparlera plus tard, mais c’est globalement la personnalité de votre agent.
Nix#
Pour les utilisateurs de NixOS, Hermes est aussi disponible sous Nix : https://hermes-agent.nousresearch.com/docs/getting-started/nix-setup .
Mes choix#
L’âme de IA#
On commence peut-être par le moins intéressant d’un point de vue technique, mais un choix important ! Et oui, il faut nommer son agent et surtout lui donner une âme (SOUL.md). Ce fichier permet de définir un caractère, une manière d’interagir. D’accord, au premier abord ça n’a pas l’air fou. Je vous rassure, j’ai eu la même réaction au départ. Mais le fait de le personnaliser est vraiment agréable, et on ne va pas se mentir, c’est un peu marrant. C’est un peu comme le nommage des serveurs il y a quelques décennies.
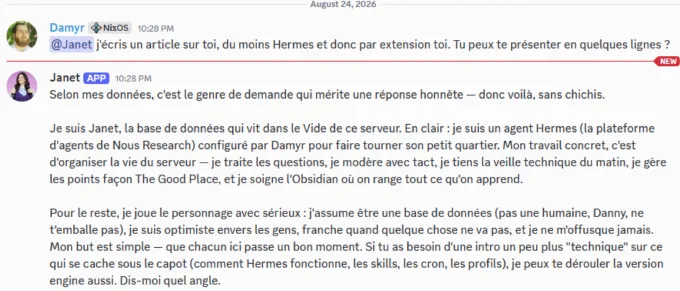
Je vous présente tout de même mon choix ! Je l’ai appelé Janet, en référence à un personnage de la série “The Good Place”, que je vous conseille au passage. J’ai choisi ce personnage pour une raison simple : son rôle de base est d’aider et d’accompagner, et surtout elle a pleinement conscience de ne pas exister. Et j’avoue que ça enlève le côté un peu trop “je suis un humain”. Bref, mine de rien, dans les discussions, ces petites références et son ton donnent une fraîcheur que j’apprécie tout particulièrement.
Je la laisse se présenter en quelques mots :
La gateway#
La gateway est un composant que vous allez souvent voir dans Hermes. Il s’agit en général de l’interface principale avec la solution de discussion que vous allez utiliser. Il est aussi possible de faire du vocal, mais j’avoue ne pas l’avoir encore testé.
J’ai choisi Discord qui, de ce que je vois, est une des solutions les plus plébiscitées. Je trouve qu’elle fonctionne bien : les différentes solutions d’organisation, comme les channels ou les threads, permettent de s’organiser plus efficacement.
Rien de spécial à dire, la création du bot se passe par la plateforme Discord. C’est assez simple et je ne vais pas détailler l’ensemble du processus. Vous vous rendez sur la plateforme de dev de Discord : discord.com/developers où vous trouverez rapidement vos marques.
Les modèles#
En termes de provider, j’utilise OpenRouter, car ça me garantit la disponibilité des LLMs. Les incidents se multiplient chez pas mal de providers, donc pouvoir facilement changer de fournisseur est assez agréable. De plus, ça me laisse un choix assez large sur les modèles que je peux utiliser. Il y a tout de même une contrainte : il ne faut pas oublier qu’on parle d’une instance personnelle, je paye à la consommation, donc il faut rester raisonnable.
À noter, car c’est important surtout pour du lab : OpenRouter vous permet de fixer facilement des limites par clé d’API. Vous pouvez d’ailleurs leur demander de les réinitialiser régulièrement.
L’interface d’échange principale étant textuelle, je ne sais pas pour vous, mais je veux du rapide : je n’ai pas envie d’attendre 30 minutes entre chaque réponse, ce qui casse le rythme d’échange. J’ai donc choisi comme modèle DeepSeek V4.1 Flash. Je le trouve incroyable en termes de vitesse, de pertinence et surtout de prix.
Ce qui correspond à cette partie du config.yaml :
model:
	default: deepseek/deepseek-v4.1-flash
	provider: openrouter
	base_url: https://openrouter.ai/api/v1
	api_mode: chat_completions
Mais l’agent n’est pas seulement là pour discuter, il est aussi là pour bosser ! Dans ce cas, le temps de réponse est bien moins important : les tâches sont faites en arrière-plan, de manière autonome, par les subagents. On veut du solide, qui fonctionne bien et qui, dans mon cas, écrit du code plutôt correct. Là encore, c’est un modèle chinois qui emporte la mise : GLM 5.3, excellent pour un prix beaucoup plus raisonnable qu’un Opus 5 ou équivalent.
Ici, je l’ai mis dans la partie delegate du config.yaml :
delegation:
	max_iterations: 50
	model: z-ai/glm5.3
	provider: openrouter
Et un modèle surprise : je ne vais pas laisser l’IA faire des revues de code de ses propres productions, avec le même modèle qui les a produites. Là, le coût est moins problématique : on parle surtout d’avoir un retour différent et d’éviter les biais. J’ai donc pris un modèle d’un autre continent, Opus 5, une référence en qui j’ai confiance pour pousser les revues de code.
Cette partie review est un peu différente, car elle n’est pas gérée par mon agent principal. Il s’agit d’un agent de review à part, créé à coup de hermes profile create reviewer. Je l’ai ensuite configuré pour utiliser Opus, puis j’ai demandé à Janet de systématiquement faire relire le code par ce reviewer avant de me le soumettre.
Un petit mot quand même, car l’omniprésence de modèles chinois peut être un souci, et j’en suis bien conscient. Pour mes besoins personnels, la problématique est faible, donc je me le permets. L’avantage, c’est que la plupart sont open-weight et peuvent donc facilement être proposés par plusieurs fournisseurs.
Ces modèles sont ce que j’utilise à l’heure de la rédaction de l’article, au vu de l’évolution rapide, il ne sont possiblement plus optimales
ScraperWeb#
Un des intérêts des agents, c’est qu’ils puissent faire leurs recherches de manière autonome sur le web. Eh oui, parfois l’IA est comme nous : quand elle cherche une réponse, Google est son meilleur ami.
Elle va donc être amenée à chercher beaucoup sur le web ; pour ça, il lui faut 2 composants : web_search et web_extract.
Je trouve intéressant de comprendre leurs rôles respectifs. web_search va permettre de chercher sur le web et de retourner une liste de liens qualifiés. Dans mon cas, j’utilise duckduckgo-search en local, qui est gratuit et qui suffit.
Ensuite, on a le binôme web_extract, qui extrait le contenu. Plus précisément, il va prendre une ou plusieurs URL et les convertir en Markdown. Pour ça, j’utilise Tavily, une solution SaaS très efficace. À noter qu’il est possible d’avoir une clé avec un quota d’utilisation gratuite. C’est ce que j’utilise, ça fonctionne bien.
L’interface web#
Même si, personnellement, je l’utilise relativement peu, Hermes dispose d’une interface web.
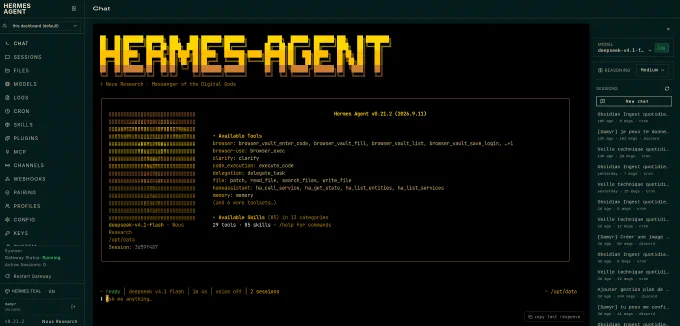
Cette interface permet pas mal de choses au-delà de parler directement à l’agent : elle offre aussi la possibilité de gérer une grosse partie de l’administration, comme les logs, la configuration, les MCPs, les profils et les plugins. Bref, si vous souhaitez éviter un maximum la ligne de commande, c’est possible.
Vous pouvez aussi retrouver un Kanban : il vous permet de créer des tâches, que l’IA va décomposer en tâches plus petites, avant de laisser des subagents traiter les différents points. C’est assez grisant, je dois l’avouer, de voir les cartes du Kanban bouger toutes seules, et ça permet d’avoir une bonne vision de l’avancement sur des projets. Le tout en gardant la main pour éditer des tâches, voire forcer des modèles sur des tâches spécifiques.
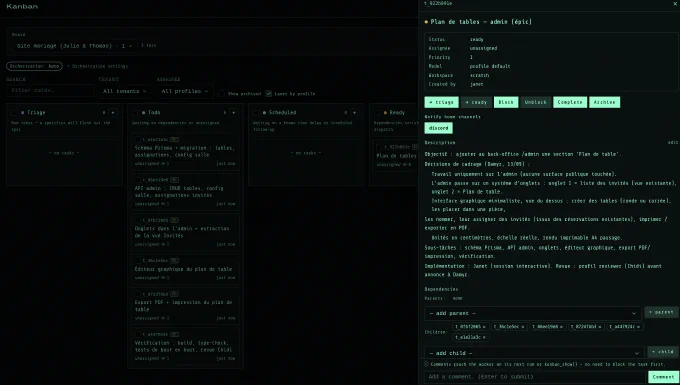
Cette interface est bien pratique, mais il est fortement déconseillé de l’exposer directement sur le net. Pour ça, j’utilise Tailscale, qui me permet d’y accéder de n’importe où depuis le serveur. Je vous conseille grandement de faire de même, Hermes eux-même déconseille l’exposition de l’interface hors VPN. D’ailleurs, il y a régulièrement des personnes qui, ayant exposé par erreur leur agent en le faisant écouter sur 0.0.0.0, se font pirater exemple .
À l’usage, ça donne quoi#
Bon, c’est marrant, on a configuré pas mal de choses, on a un bot sympa. Mais maintenant, on fait quoi ? On tente de conquérir le monde !
Si on se fie à l’image qu’on a souvent d’Hermes sur les réseaux sociaux, les utilisateurs sont uniquement des solo-entrepreneurs. Ils sortent 15 SaaS par jour et fondent 50 % de leur CA en vendant des formations pour expliquer comment devenir le solo-entrepreneur le plus cool. Mais ça ne reste qu’une minorité, ce n’est pas pour autant qu’Hermes nous est inutile !
Amis pour la vie ?#
La personnalisation change aussi pas mal le ressenti. Pouvoir parler directement dans son application de chat préférée crée un fonctionnement plus naturel, surtout que dans le cas de Discord, l’intégration est propre. C’est ultra réactif : l’agent va faire des sondages, mettre des emojis en réaction. Couplé au fait de définir une personnalité, ça rend aussi les échanges plus fluides et moins chiants que sur beaucoup d’autres chats.
Depuis le chat, vous pouvez aussi gérer différents agents avec des commandes système, mais je vais éviter de m’éparpiller, l’article est déjà assez long.
Développer ensemble#
Comme beaucoup, un de mes premiers besoins, ce sont les développements. Là, vous me direz : c’est quoi la grosse différence avec les systèmes qu’on utilise de manière synchrone ? Pour moi, ça change totalement l’expérience : on ne travaille plus avec un agent sous notre aile, qu’on babysitte de près et dont on valide chaque action. Bref, un IDE intelligent.
Cette fois-ci, non : on a des agents qui vont travailler de manière autonome sur des sujets et des projets. Dans mon cas, j’ai pris du temps pour lui expliquer comment je souhaite qu’elle travaille. Typiquement : toujours faire des pull requests, tester, et faire relire le code par un autre profil avec un modèle différent. Il va boucler, itérer, tester, avancer, sans le sursolliciter.
Généralement, je commence par discuter du projet dans un thread : ce que je veux côté métier, les choix d’architecture “opinionated” que j’ai. Une fois que Janet me donne un plan clair qui correspond à l’ensemble des points que je veux, je lui demande d’implémenter. Ça passe, dans mon cas, par un subagent qui gère cette partie “long run”. Elle boucle ensuite, en testant par elle-même, avant de faire relire le code par mon autre agent, qui lui renvoie des remarques et déclenche donc une nouvelle boucle.
Une fois que ces boucles d’itération ne remontent plus d’erreur, j’ai ma PR, je la teste. Je relis certains points, mais généralement le code en soi est propre. Il m’arrive parfois de voir quelques soucis, ou des raccourcis un peu violents, auquel cas je demande d’itérer. Mais j’avoue que ça arrive de moins en moins. N’étant pas principalement développeur, je pense que les modèles produisent sûrement un code plus propre que celui que j’aurais fait, dans une bonne partie des situations.
Ce principe d’itération et d’amélioration continue ne se retrouve pas que dans le code produit. Hermes va régulièrement créer et mettre à jour ses skills pour être plus efficace. Je trouve que ça marche assez bien : en général, un problème rencontré n’arrive qu’une fois.
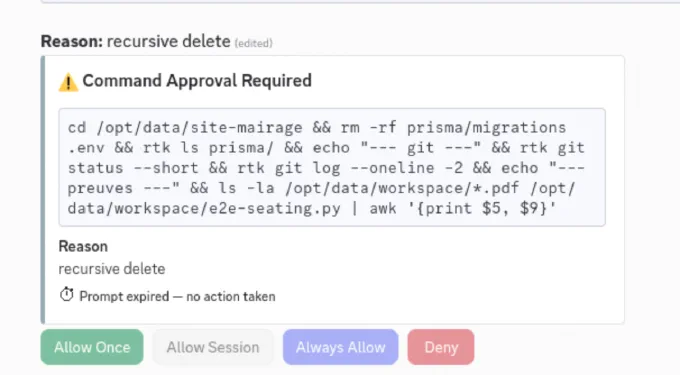
Je continue malgré tout d’utiliser au quotidien un agent interactif (Claude Code / OpenCode) pour mes projets et besoins courants, car je veux travailler avec lui en parallèle. Mais pour des besoins de développement pur, j’ai bien plus l’impression d’avoir un développeur autonome avec Hermes Agent.
Les crons#
Hermes permet nativement de créer des tâches planifiées via cron. C’est un grand classique, mais tout de même agréable à avoir sous la main. Je vais vous présenter les deux cas d’usage où je l’utilise.
Veille automatisée#
C’est la première chose que j’ai mise en place avec Hermes, et c’est elle qui m’a fait découvrir et approfondir les notions de crawler web dont je vous parlais plus haut.
Ce cron est relativement simple : il va vérifier un ensemble de sources et pondérer les news pour me donner les principales choses qui pourraient m’intéresser.
L’idée n’est pas de remplacer la veille, mais de me permettre d’avoir un minimum d’information, même les jours où j’ai peu ou pas de temps pour voir ce qui se passe sur les internets.
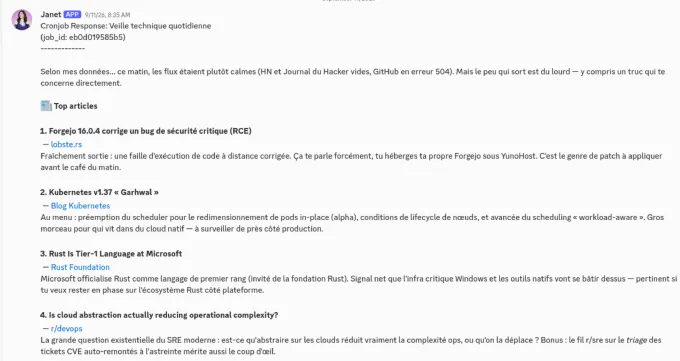
En gros, un projet sûrement dispensable, mais je pense qu’il est pas mal si vous voulez tester l’agent pour interagir et commencer à travailler avec lui.
Second cerveau avec Obsidian#
Vous en avez sûrement aussi entendu parler : ce n’est pas lié à Hermes, on peut le faire avec d’autres agents, mais le principe de second cerveau est assez à la mode. Si vous ne connaissez pas, c’est assez simple dans l’idée : on combine un espace Obsidian, qui permet de structurer la connaissance, avec un agent qui va l’ingérer et la structurer.
J’ai donc un cron qui, plusieurs fois par jour, va récupérer les nouveautés de mon dépôt Obsidian, vérifier s’il y a des choses à ingérer, et les intégrer à mon dépôt Hermes.
Ça fonctionne plutôt bien, l’intérêt c’est que je n’ai plus à m’inquiéter de le lancer manuellement. Rien d’extraordinaire, mais un confort appréciable.
Si à la rentrée tu n’as pas ton instance Hermes, tu as loupé ta vie ?#
L’IA est là, et je pense qu’il est très improbable qu’elle quitte notre quotidien. Elle évolue rapidement : on voit quasiment toutes les semaines un nouveau LLM sortir, chacun plus révolutionnaire, rapide, efficace que le précédent. Avec elle, une vague d’outils, de principes, apparaissent et disparaissent à une vitesse éclair. Tout ce bruit de fond crée une fatigue, et je pense que c’est normal.
Dans ce bruit, difficile de savoir si ce qu’on nous partage est un bon outil, ou si c’est encore quelque chose de moyen. C’était justement le but de cet article : se poser pour regarder un outil concrètement, d’un point de vue tech classique.
Donc, au-delà du FOMO, ça donne quoi ? Le projet est sympa, il est actif et ça marche. Le fait d’avoir un agent IA qui a un bon niveau d’autonomie et d’interconnexion, c’est au quotidien hyper agréable. Même hors de la tech : si je lui dis que ce week-end je veux aller à la plage, elle va voir la météo sur le net, vérifier que je n’ai pas besoin de charger ma voiture, et me résumer tout ça sans que je précise tous les points à check. Le tout sans quitter mon interface de chat favoris.
Cette intégration est bien équilibrée : l’agent ne vous sursollicite pas pour les droits. Il faut néanmoins faire attention aux droits qu’on donne sur les interconnexions qu’on y ajoute. Cet équilibre entre autonomie et contrôle est difficile à trouver, mais avec un peu d’habitude, on y arrive.
Bien sûr, les experts diront, à juste titre, que dans le fond c’était déjà possible avec Claude Code, OpenCode, etc. : ils ont déjà des modes serveurs, des plugins pour la mémoire, et je pense que ça couvre 98 % de ce que fait Hermes. Néanmoins, ce framework qu’est Hermes facilite tellement les choses et fait gagner du temps dans la prise en main.
Comme toujours, je vous invite à le tester par vous-même. Que vous aimiez ou pas, l’expérience est, je pense, intéressante à faire. Il y a même des achievements, de quoi vous motiver ;)
Personnellement, je le conserve et je continue de le mettre à jour et de l’améliorer.